Линейная регрессия: свойства МНК, инференция и ограничения
1 Зачем возвращаться к линейной регрессии?
Базовая линейная регрессия уже знакома нам из математической статистики. Здесь нас будут интересовать вопросы, которые возникают после стандартной формулы МНК:
Что именно измеряет \(R^2\) и почему при добавлении регрессоров он почти всегда растёт?
Какие свойства МНК требуют нормальности ошибок, а какие — нет?
Что остаётся верным, если отказаться от нормальности?
Когда МНК является BLUE?
Как оценивать неизвестную дисперсию ошибки?
Как строить точные и асимптотические тесты?
Как одновременно тестировать несколько коэффициентов?
Что делать, если о параметрах заранее известны дополнительные ограничения?
Рассматриваем модель
\[
Y=X\beta+\varepsilon,
\]
где \(Y\in\mathbb R^n\), \(X\in\mathbb R^{n\times k}\), \(\beta\in\mathbb R^k\).
2 Что мы уже знаем о нормальной линейной модели
До этого момента мы в основном работали с гауссовской линейной моделью
Таким образом, при нормальности ошибок мы знаем не только точное распределение \(\hat\theta\), но и точное распределение остаточной суммы квадратов, причём эти две случайные величины условно независимы при фиксированном \(X\).
Именно эти свойства лежат в основе точных \(t\)- и \(F\)-тестов.
2.4 Проверка линейных гипотез
TipКак мы до сих пор проверяли несколько линейных ограничений на параметры?
Благодаря этому мы можем строить точные \(t\)- и \(F\)-тесты.
Однако предположение о нормальности ошибок является достаточно сильным.
Поэтому теперь естественно задать следующие вопросы:
Что останется верным, если ошибки не являются нормальными?
Будет ли МНК-оценка
\[
\hat\theta=(X^\top X)^{-1}X^\top Y
\]
по-прежнему несмещённой?
Будет ли она по-прежнему оптимальной среди других оценок?
Если точная нормальность \(\hat\theta\) исчезает, будет ли \(\hat\theta\) хотя бы асимптотически нормальной при \(n\to\infty\)?
Можно ли без нормальности по-прежнему строить тесты гипотез о компонентах \(\theta\)?
Какие предположения действительно нужны для:
несмещённости;
состоятельности;
эффективности;
асимптотической нормальности;
статистического тестирования?
Наконец, что изменится, если у нас имеется дополнительная априорная информация о параметрах, например
\[
R\theta=r?
\]
Можно ли использовать эту информацию, чтобы получить более точную оценку, чем обычная МНК-оценка?
Таким образом, далее наша задача состоит в том, чтобы понять, какие свойства МНК являются следствием самой линейной структуры модели, а какие зависят от дополнительных предположений об ошибках.
4 1. Геометрия оценённой линейной модели
TipВопрос
На какие две части МНК разбивает наблюдаемый вектор \(Y\) и почему это разложение полезно?
МНК-оценка:
\[
\hat\beta=(X^\top X)^{-1}X^\top Y.
\]
Предсказанные значения равны
\[
\hat Y=X\hat\beta
=X(X^\top X)^{-1}X^\top Y
=P_XY,
\]
где
\[
P_X=X(X^\top X)^{-1}X^\top
\]
— матрица ортогональной проекции на пространство столбцов \(X\).
Остатки:
\[
\hat\varepsilon=Y-\hat Y=(I-P_X)Y.
\]
Следовательно,
\[
\boxed{Y=\hat Y+\hat\varepsilon.}
\]
При этом
\[
X^\top\hat\varepsilon=0,
\]
то есть остатки ортогональны каждому столбцу матрицы регрессоров.
4.1 1.1. Разложение вариации
TipВопрос
Как количественно разделить общую вариацию \(Y\) на объяснённую моделью и оставшуюся в остатках?
Если модель содержит константу, то
\[
\sum_{i=1}^n\hat\varepsilon_i=0,
\qquad
\overline{\hat Y}=\bar Y.
\]
Последнее равенство является специальным свойством парной регрессии с константой.
5.2 2.2. Почему обычный \(R^2\) опасен при сравнении моделей?
TipВопрос
Если новый регрессор почти бесполезен, может ли добавление его в модель ухудшить \(R^2\)?
Нет. При добавлении новых столбцов в \(X\) множество допустимых линейных предсказаний только расширяется. Поэтому минимальный \(SSR\) не может увеличиться:
\[
SSR_{\text{new}}\le SSR_{\text{old}}.
\]
Следовательно,
\[
R^2_{\text{new}}\ge R^2_{\text{old}}.
\]
Это происходит даже тогда, когда дополнительная переменная почти ничего не объясняет.
5.3 2.3. Скорректированный \(R^2\)
TipВопрос
Как сравнивать модели с разным числом регрессоров, штрафуя модель за лишние параметры?
Пусть \(k\) — число оцениваемых коэффициентов включая константу. Тогда
Чем \(E(\varepsilon)=0\) отличается от гораздо более сильного условия \(E(\varepsilon\mid X)=0\)?
Условие
\[
E(\varepsilon)=0
\]
говорит только, что ошибки компенсируются в среднем по всей популяции.
Условие
\[
E(\varepsilon\mid X)=0
\]
говорит, что ошибки имеют среднее ноль при каждом фиксированном значении регрессоров.
Например, при прогнозировании цены квартиры по площади:
\(E(\varepsilon)=0\) допускает, что модель систематически завышает цены маленьких квартир и занижает цены больших, если эти ошибки в среднем компенсируются;
\(E(\varepsilon\mid X)=0\) требует отсутствия такой систематической ошибки при каждой площади \(X\).
при нормальных ошибках \(t\)-распределение является точным;
без нормальности нормальная аппроксимация является асимптотической.
14 11. Дополнительная информация о параметрах: ограниченный МНК
TipВопрос
Что делать, если мы заранее точно знаем, что истинные коэффициенты удовлетворяют некоторым линейным ограничениям? Можно ли использовать эту информацию для более точного оценивания?
Пусть известно
\[
\boxed{R\beta=r},
\]
где \(R\in\mathbb R^{q\times k}\) имеет ранг \(q\).
Но если ограничение ошибочно, выигрыш в дисперсии покупается ценой смещения. Поэтому известное ограничение и гипотеза, которую ещё нужно проверить, — принципиально разные ситуации.
15 12. Три подхода к проверке ограничений
Пусть
\[
H_0:g(\beta)=0
\]
задаёт \(q\) ограничений.
TipВопрос
Как можно измерить несовместимость данных с ограничением \(H_0\)?
Существуют три классических ответа:
Тест
Основная идея
Wald
Насколько неограниченная оценка \(\hat\beta\) далека от множества \(H_0\)?
LR
Насколько ухудшается максимальное правдоподобие, если навязать\(H_0\)?
LM / Score
Если оценить модель только под \(H_0\), насколько сильно функция правдоподобия хочет двигаться прочь от ограничения?
При стандартных регулярных условиях все три статистики асимптотически имеют распределение
\[
\chi_q^2.
\]
16 13. LR-тест
TipВопрос
Насколько сильно ограничение ухудшает качество подгонки модели?
При нормальных ошибках профильная логарифмическая функция правдоподобия имеет вид
\[
SSR(\hat\beta_R)-SSR(\hat\beta)
=
(\hat\beta_R-\hat\beta)^\top
X^\top X
(\hat\beta_R-\hat\beta).
\]
То есть потеря качества подгонки измеряет расстояние между ограниченной и неограниченной оценками в геометрии, задаваемой \(X^\top X\).
17 14. LM / Score-тест
TipВопрос
Можно ли проверить \(H_0\), оценивая только ограниченную модель, не вычисляя неограниченную оценку?
Да. В точке \(\hat\beta_R\) ограниченная модель оптимальна вдоль множества ограничений, но градиент полной функции правдоподобия вообще говоря не равен нулю.
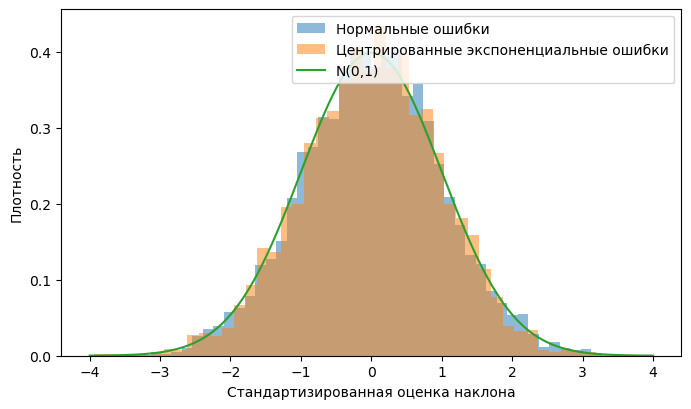
При нормальных ошибках нормальность \(\hat\beta\) является точной уже при фиксированном \(n\).
При ненормальных ошибках точной нормальности нет, но при увеличении \(n\) распределение стандартизированной оценки обычно приближается к нормальному благодаря ЦПТ.
20 17. Итоговая логика темы
Линейная регрессия полезна не только потому, что
\[
\hat\beta=(X^\top X)^{-1}X^\top Y
\]
легко вычисляется. Важнее понимать, какие выводы можно делать при разных наборах предположений.
Геометрия МНК даёт разложение \(Y=\hat Y+\hat\varepsilon\) и \(SST=SSE+SSR\).
\(R^2\) измеряет качество подгонки, но автоматически выигрывает от дополнительных регрессоров; поэтому появляется \(R^2_{\mathrm{adj}}\).
Нормальность не нужна ни для вычисления МНК, ни для BLUE-свойства.
Нормальность даёт точные конечновыборочные распределения и классические \(t\)- и \(F\)-тесты.
Без нормальности центральными становятся состоятельность и асимптотическая нормальность.
Если известны истинные ограничения \(R\beta=r\), их можно встроить в оценивание и уменьшить дисперсию.
Если ограничения лишь предполагаются, их проверяют с помощью Wald, LR, LM или классического \(F\)-теста в соответствующей постановке.
Таким образом, главный вопрос продвинутого анализа регрессии — не «как посчитать МНК?», а:
какие свойства оценки и какие процедуры инференции остаются корректными при том наборе предположений, который мы действительно готовы сделать?