Seminar 10: Проверка линейных гипотез в гауссовской регрессионной модели
Author
Carlos Buitrago
1 1. Гауссовская линейная модель
Пусть \(X=Z\theta+\varepsilon\), где \(X\in\mathbb R^n\), \(Z\in\mathbb R^{n\times k}\) — известная матрица полного столбцового ранга \(k<n\), \(\theta\in\mathbb R^k\), а \(\varepsilon\sim\mathcal N_n(0,\sigma^2I_n)\), \(\sigma^2>0\).
Оценка МНК и остаточная сумма квадратов: \[\widehat\theta=(Z^TZ)^{-1}Z^TX,\qquad RSS=\|X-Z\widehat\theta\|^2.\]
Причём \[\widehat\theta\sim\mathcal N_k\big(\theta,\sigma^2(Z^TZ)^{-1}\big),\quad \frac{RSS}{\sigma^2}\sim\chi^2_{n-k},\quad \widehat\theta\perp RSS.\]
ImportantЛинейная гипотеза
\[H_0:T\theta=\tau,\qquad H_1:T\theta\ne\tau,\] где \(T\in\mathbb R^{m\times k}\), \(\tau\in\mathbb R^m\), \(\operatorname{rank}(T)=m\le k\). При \(H_0\) параметр лежит в аффинном подпространстве размерности \(k-m\) (не обязательно линейном, если \(\tau\ne0\)).
Утверждение.\(\widehat t=T\widehat\theta\) — оптимальная (в смысле минимальной ковариационной матрицы среди несмещённых линейных оценок; при нормальности также UMVU) оценка \(T\theta\).
Обоснование: следует из теоремы Гаусса—Маркова; в нормальной модели достаточность и полнота соответствующей статистики дают UMVU.
2 2. Распределение Фишера
TipОпределение
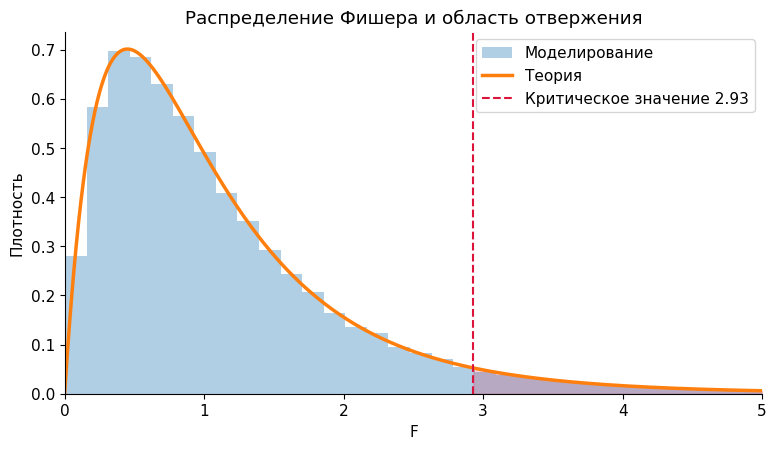
Если \(U\sim\chi^2_a\), \(V\sim\chi^2_b\) независимы, то \[F=\frac{U/a}{V/b}\sim F_{a,b}.\] Числа \(a,b\) называются степенями свободы числителя и знаменателя.
Критическая область правостороннего критерия: \(F>F_{a,b;1-\alpha}\), где \(F_{a,b;1-\alpha}\) — квантиль уровня \(1-\alpha\).
Show Python code
import numpy as npimport matplotlib.pyplot as pltfrom scipy import statsrng = np.random.default_rng(2026)plt.rcParams.update({'figure.figsize':(9,4.7),'axes.spines.top':False,'axes.spines.right':False,'font.size':11})N=60000; a,bdf=4,18u=rng.chisquare(a,N); v=rng.chisquare(bdf,N); f=(u/a)/(v/bdf)xx=np.linspace(0,5,600); crit=stats.f.ppf(.95,a,bdf)fig,ax=plt.subplots();ax.hist(f,bins=100,density=True,alpha=.35,label='Моделирование');ax.plot(xx,stats.f.pdf(xx,a,bdf),lw=2.5,label='Теория');ax.axvline(crit,color='crimson',ls='--',label=f'Критическое значение {crit:.2f}');ax.fill_between(xx,stats.f.pdf(xx,a,bdf),where=xx>=crit,alpha=.2,color='crimson');ax.set(xlim=(0,5),title='Распределение Фишера и область отвержения',xlabel='F',ylabel='Плотность');ax.legend();plt.show()print('Доля в критической области:',round(np.mean(f>crit),4))
Доля в критической области: 0.0486
3 3. Точный F-критерий линейных ограничений
Положим \(B=T(Z^TZ)^{-1}T^T\). Из условия \(\operatorname{rank}(T)=m\) следует, что \(B\) обратима.
ImportantF-тест (критерий Фишера)
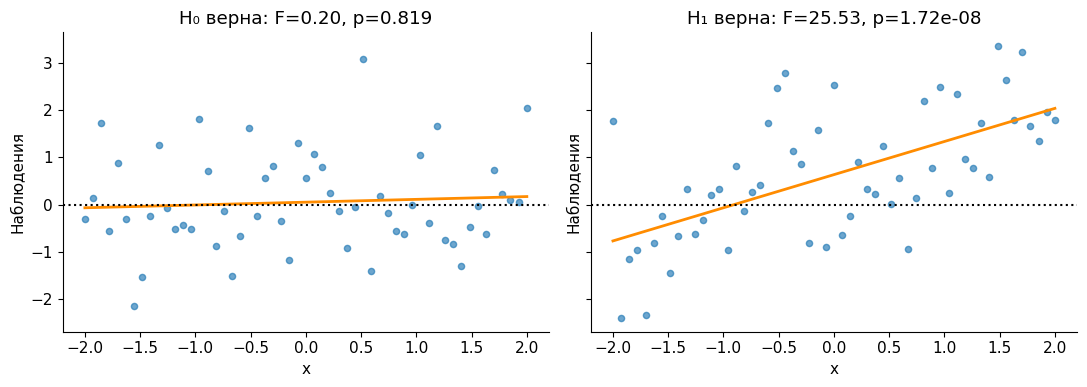
При верной \(H_0\) статистика \[F_{\mathrm{obs}}=\frac{(T\widehat\theta-\tau)^TB^{-1}(T\widehat\theta-\tau)/m}{RSS/(n-k)}\sim F_{m,n-k}.\] Гипотеза отвергается на уровне \(\alpha\), если \[F_{\mathrm{obs}}>F_{m,n-k;1-\alpha}.\]\(p\)-значение равно \(1-F_{m,n-k}^{\mathrm{CDF}}(F_{\mathrm{obs}})\).
Почему это верно? При \(H_0\) вектор \(B^{-1/2}(T\widehat\theta-\tau)/\sigma\) стандартный гауссовский размерности \(m\), поэтому квадрат его нормы имеет распределение \(\chi_m^2\). Независимая остаточная сумма квадратов, делённая на \(\sigma^2\), имеет распределение \(\chi^2_{n-k}\). Их нормированное отношение — распределение Фишера.
Эквивалентная форма:\(F=((RSS_0-RSS_1)/m)/(RSS_1/(n-k))\), где \(RSS_0\) — минимум при ограничениях, а \(RSS_1\) — без ограничений.
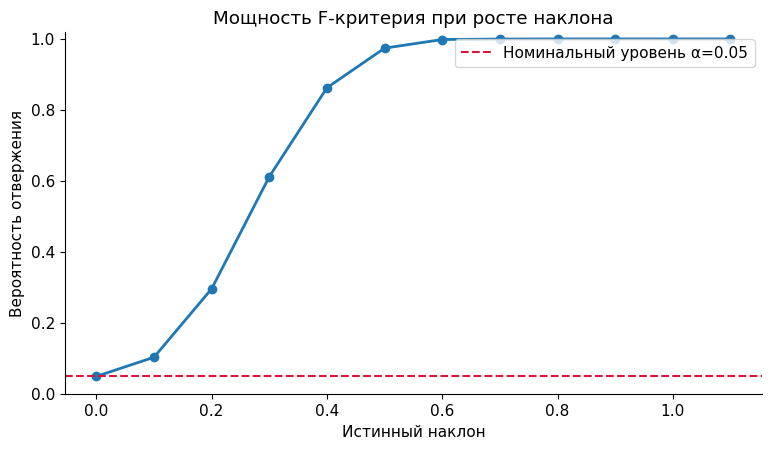
# Проверка уровня значимости и построение кривой мощностиR=3500; alpha=.05; effects=np.linspace(0,1.1,12); rates=[]for effect in effects: hits=0for _ inrange(R): y=Z@np.array([0.,effect])+rng.normal(0,sigma,nobs) hits += f_test(y)[1]<alpha rates.append(hits/R)fig,ax=plt.subplots();ax.plot(effects,rates,'o-',lw=2);ax.axhline(alpha,ls='--',color='crimson',label='Номинальный уровень α=0.05');ax.set(title='Мощность F-критерия при росте наклона',xlabel='Истинный наклон',ylabel='Вероятность отвержения',ylim=(0,1.02));ax.legend();plt.show()print('Оценка ошибки I рода:',rates[0])
Оценка ошибки I рода: 0.048857142857142856
4 4. Критерий Вальда
Рассмотрим скалярную гипотезу \(H_0:\theta=\theta_0\) против \(H_1:\theta\ne\theta_0\) и предположим, что \[\sqrt n(\widehat\theta-\theta)\xrightarrow{d}\mathcal N(0,\sigma^2(\theta)),\qquad \frac{\widehat\sigma}{\sigma(\theta)}\xrightarrow{P}1.\]
TipКритерий Вальда
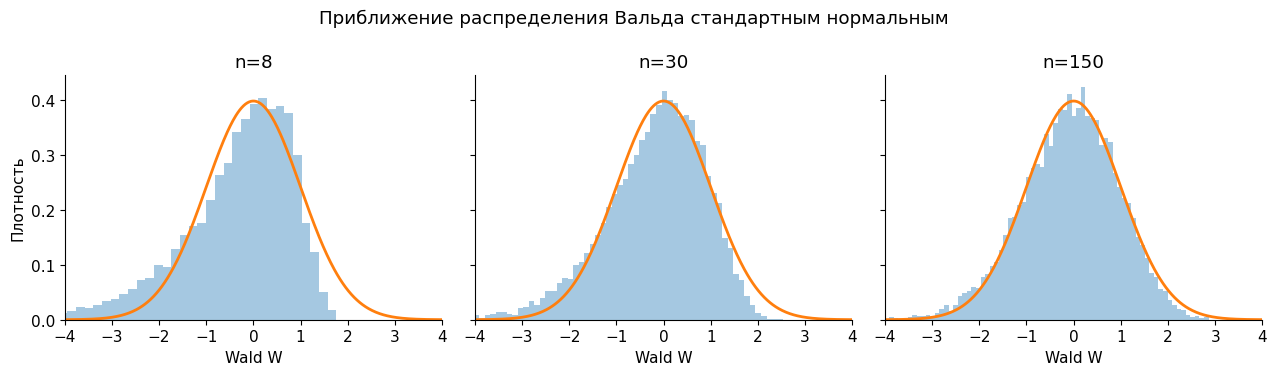
По теореме Слуцкого \[W_n=\frac{\sqrt n(\widehat\theta-\theta_0)}{\widehat\sigma}\xrightarrow[H_0]{d}\mathcal N(0,1).\] Приближённая критическая область: \(|W_n|>z_{1-\alpha/2}\).
Для векторного параметра \(\theta\in\mathbb R^k\) и \(m\) ограничений при подходящих условиях \[W_n=n\,(T\widehat\theta-\tau)^T(T\widehat V T^T)^{-1}(T\widehat\theta-\tau)\xrightarrow[H_0]{d}\chi^2_m,\] где \(\widehat V\) состоятельно оценивает асимптотическую ковариационную матрицу \(\sqrt n(\widehat\theta-\theta)\).
WarningВажно
Критерий Вальда обычно асимптотический, тогда как F-критерий выше точный при нормальных гомоскедастичных ошибках. Состоятельности \(\widehat\sigma\) самой по себе недостаточно: нужна корректная асимптотическая нормальность и положительная предельная дисперсия.
Show Python code
# Вальд для среднего экспоненциального распределения: theta = E[X]# Для Exp(scale=theta): sqrt(n)*(Xbar-theta)/theta -> N(0,1)fig,axs=plt.subplots(1,3,figsize=(13,3.8),sharey=True)for ax,nn inzip(axs,[8,30,150]): samples=rng.exponential(scale=2.,size=(12000,nn)) means=samples.mean(axis=1) w=np.sqrt(nn)*(means-2.)/means grid=np.linspace(-4,4,400) ax.hist(w,bins=85,density=True,alpha=.4);ax.plot(grid,stats.norm.pdf(grid),lw=2) ax.set(xlim=(-4,4),title=f'n={nn}',xlabel='Wald W')axs[0].set_ylabel('Плотность');fig.suptitle('Приближение распределения Вальда стандартным нормальным');plt.tight_layout();plt.show()
5 5. Одновыборочный t-критерий Стьюдента
Пусть \(X_1,\ldots,X_n\overset{iid}{\sim}\mathcal N(a,\sigma^2)\), дисперсия неизвестна. Проверяем \(H_0:a=a_0\) против \(H_1:a\ne a_0\).
Определим \(\overline X=n^{-1}\sum_i X_i\), \(S^2=n^{-1}\sum_i(X_i-\overline X)^2\) и \(s^2=(n-1)^{-1}\sum_i(X_i-\overline X)^2\).
ImportantТочная статистика
\[t=\frac{\sqrt n(\overline X-a_0)}{s}=\sqrt{n-1}\frac{\overline X-a_0}{\sqrt{S^2}}\sim_{H_0}t_{n-1}.\] Отвергаем \(H_0\), если \(|t|>t_{n-1;1-\alpha/2}\).
Доказательство:\(\sqrt n(\overline X-a_0)/\sigma\sim\mathcal N(0,1)\) и \((n-1)s^2/\sigma^2\sim\chi^2_{n-1}\) независимы. Следовательно, их отношение имеет распределение Стьюдента.
Доверительный интервал уровня \(1-\alpha\): \(\overline X\pm t_{n-1;1-\alpha/2}\,s/\sqrt n\).
Show Python code
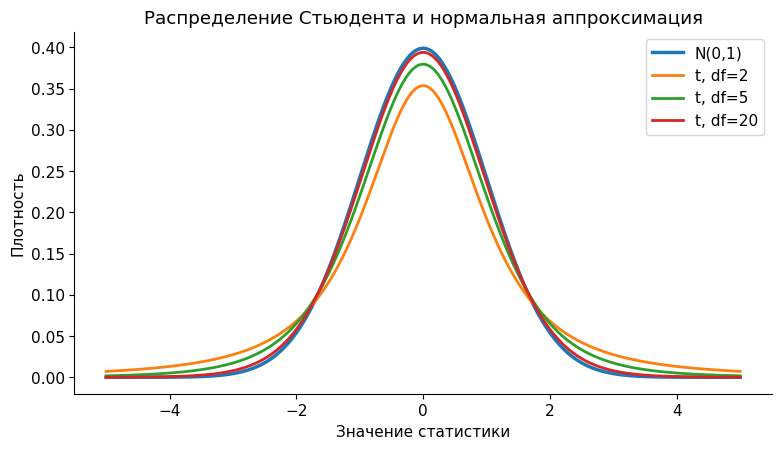
# t-распределение имеет более тяжёлые хвосты, чем N(0,1)grid=np.linspace(-5,5,700);fig,ax=plt.subplots()ax.plot(grid,stats.norm.pdf(grid),lw=2.5,label='N(0,1)')for df in [2,5,20]:ax.plot(grid,stats.t.pdf(grid,df),lw=2,label=f't, df={df}')ax.set(title='Распределение Стьюдента и нормальная аппроксимация',xlabel='Значение статистики',ylabel='Плотность');ax.legend();plt.show()# Проверка t-критерия моделированиемNsim=30000; nn=12; xx=rng.normal(loc=0,scale=2,size=(Nsim,nn)); tt=np.sqrt(nn)*xx.mean(axis=1)/xx.std(axis=1,ddof=1)q=stats.t.ppf(.975,nn-1)print('Доля отвержений при верной H0:',np.mean(abs(tt)>q))
Доля отвержений при верной H0: 0.0507
6 6. Двухвыборочный t-критерий (равные дисперсии)
Пусть независимы \(X_1,\ldots,X_n\overset{iid}{\sim}\mathcal N(a_1,\sigma^2)\) и \(Y_1,\ldots,Y_m\overset{iid}{\sim}\mathcal N(a_2,\sigma^2)\). Проверяем \(H_0:a_1=a_2\) против \(H_1:a_1\ne a_2\).
Обозначим \(s_X^2=\frac1{n-1}\sum_i(X_i-\overline X)^2\), \(s_Y^2=\frac1{m-1}\sum_j(Y_j-\overline Y)^2\) и объединённую дисперсию \[s_p^2=\frac{(n-1)s_X^2+(m-1)s_Y^2}{n+m-2}.\]
ImportantДвухвыборочный t-критерий
\[t=\frac{\overline X-\overline Y}{s_p\sqrt{1/n+1/m}}=\sqrt{\frac{nm}{n+m}}\frac{\overline X-\overline Y}{s_p}\sim_{H_0}t_{n+m-2}.\] Отвергаем \(H_0\), если \(|t|>t_{n+m-2;1-\alpha/2}\).
Примечание к исходному конспекту: степень свободы — именно \(n+m-2\) (не \(n-m-2\)). Если в конспекте \(S^2\) обозначает объединённую несмещённую оценку дисперсии, то \(\sqrt{S^2}=s_p\).
WarningКогда нельзя применять эту формулу?
Если дисперсии различаются, предпочтителен t-критерий Уэлча, использующий \(\sqrt{s_X^2/n+s_Y^2/m}\) и приближённое число степеней свободы Уэлча—Саттертуэйта.