Метод моментов
Пусть \(X_1,\dots,X_n\) — независимая одинаково распределённая выборка из семейства распределений \(\{P_\theta:\theta\in\Theta\}\) , где параметр \(\theta\) неизвестен.
Идея метода моментов: теоретические моменты распределения выражаются через неизвестный параметр, а затем заменяются соответствующими выборочными моментами.
Теоретические и выборочные моменты
\(k\) -м теоретическим моментом называется
\[
m_k(\theta)=\mathbb E_\theta X^k,
\]
если это математическое ожидание существует.
Соответствующий выборочный момент имеет вид
\[
\widehat m_k=\frac1n\sum_{i=1}^n X_i^k.
\]
Если параметр одномерный, обычно достаточно одного уравнения
\[
\widehat m_1=m_1(\theta).
\]
Если \(\theta=(\theta_1,\dots,\theta_k)\) — \(k\) -мерный параметр, используют систему
\[
\begin{cases}
\widehat m_1=m_1(\theta),\\
\vdots\\
\widehat m_k=m_k(\theta).
\end{cases}
\]
Если отображение
\[
m:\Theta\to m(\Theta),\qquad
m(\theta)=(m_1(\theta),\dots,m_k(\theta))
\]
обратимо, то оценка метода моментов записывается как
\[
\boxed{\widehat\theta_{\mathrm{MM}}=m^{-1}(\widehat m_1,\dots,\widehat m_k).}
\]
Пусть
\[X_1,\dots,X_n\sim\operatorname{Pois}(\lambda).\]
Так как
\[\mathbb E X=\lambda,\]
приравниваем теоретический и выборочный моменты:
\[\overline X=\lambda.\]
Следовательно,
\[\boxed{\widehat\lambda_{\mathrm{MM}}=\overline X.}\]
Если \(X\sim U[0,\theta]\) , то
\[\mathbb E X=\frac\theta2.\]
Поэтому
\[\overline X=\frac\theta2
\quad\Longrightarrow\quad
\boxed{\widehat\theta_{\mathrm{MM}}=2\overline X.}\]
Обобщённая идея моментов
Не обязательно использовать только степени \(X^k\) . Можно выбрать функцию \(g\) такую, что
\[m(\theta)=\mathbb E_\theta g(X)\]
существует и однозначно определяет \(\theta\) . Тогда можно решить уравнение
\[
\frac1n\sum_{i=1}^n g(X_i)=m(\theta).
\]
Это особенно полезно для тяжёлохвостых распределений, у которых обычные моменты могут не существовать.
Пример: распределение Коши
Пусть
\[X\sim\operatorname{Cauchy}(0,\theta),\qquad
f_\theta(x)=\frac{\theta}{\pi(x^2+\theta^2)},\quad \theta>0.\]
Обычные положительные целые моменты распределения Коши не существуют. Возьмём вместо них ограниченную функцию
\[g(x)=\frac{x^2}{1+x^2}.\]
Тогда
\[
\mathbb E_\theta g(X)
=\mathbb E_\theta\frac{X^2}{1+X^2}
=\frac{\theta}{1+\theta}.
\]
Обозначим
\[
M_n=\frac1n\sum_{i=1}^n\frac{X_i^2}{1+X_i^2}.
\]
Из моментного уравнения
\[M_n=\frac\theta{1+\theta}\]
получаем
\[
\boxed{\widehat\theta=\frac{M_n}{1-M_n}}.
\]
Сильная состоятельность оценки метода моментов
Пусть
\[m:\Theta\to m(\Theta)\]
— биекция, причём функция \(m^{-1}\) определена и непрерывна в каждой точке множества \(m(\Theta)\) . Предположим также, что
\[
\mathbb E_\theta |g_i(X_1)|<\infty,
\qquad i=1,\dots,k,
\]
для всех \(\theta\in\Theta\) , где
\[m_i(\theta)=\mathbb E_\theta g_i(X_1).\]
Тогда оценка метода моментов является сильно состоятельной :
\[
\boxed{\widehat\theta_n\xrightarrow{a.s.}\theta.}
\]
Почему это верно?
По усиленному закону больших чисел
\[
\frac1n\sum_{j=1}^n g_i(X_j)
\xrightarrow{a.s.}
\mathbb E_\theta g_i(X_1)=m_i(\theta).
\]
Следовательно,
\[\widehat m_n\xrightarrow{a.s.}m(\theta).\]
По непрерывности \(m^{-1}\) ,
\[
\widehat\theta_n=m^{-1}(\widehat m_n)
\xrightarrow{a.s.}
m^{-1}(m(\theta))=\theta.
\]
Асимптотическая нормальность оценки метода моментов
В условиях предыдущей теоремы предположим дополнительно, что \(m^{-1}\) дифференцируема в точке \(m(\theta)\) и
\[
\mathbb E_\theta[g_i(X_1)^2]<\infty,
\qquad i=1,\dots,k.
\]
Тогда оценка метода моментов асимптотически нормальна.
Действительно, многомерная ЦПТ даёт
\[
\sqrt n\left(\widehat m_n-m(\theta)\right)
\xrightarrow{d}
\mathcal N_k(0,\Sigma),
\]
где
\[
\Sigma=\operatorname{Cov}_\theta\bigl(g(X_1)\bigr).
\]
Применяя многомерный дельта-метод к \(m^{-1}\) , получаем
\[
\boxed{
\sqrt n(\widehat\theta_n-\theta)
\xrightarrow{d}
\mathcal N_k\left(0,
D m^{-1}(m(\theta))\,\Sigma\,D m^{-1}(m(\theta))^\top
\right).
}
\]
Квантили
Квантиль распределения
Для \(p\in(0,1)\) величина
\[
\boxed{z_p=\inf\{x:F_P(x)\ge p\}}
\]
называется \(p\) -квантилем\(P\) .
Например, при \(p=1/2\) получаем медиану распределения.
Выборочный квантиль
Пусть
\[X_{(1)}\le X_{(2)}\le\cdots\le X_{(n)}\]
— вариационный ряд выборки \(X_1,\dots,X_n\) .
Статистика
\[
z_{n,p}=
\begin{cases}
X_{(\lfloor np\rfloor+1)}, & np\notin\mathbb Z,\\[4pt]
X_{(np)}, & np\in\mathbb Z,
\end{cases}
\]
называется выборочным \(p\) -квантилем .
Асимптотическая нормальность выборочного квантиля
Пусть \(X_1,\dots,X_n\) — выборка из распределения \(P\) с плотностью \(\rho(x)\) . Пусть \(z_p\) — \(p\) -квантиль распределения, причём \(\rho\) непрерывна в точке \(z_p\) и
\[\rho(z_p)>0.\]
Тогда
\[
\boxed{
\sqrt n\,(z_{n,p}-z_p)
\xrightarrow{d}
\mathcal N\left(0,\frac{p(1-p)}{\rho^2(z_p)}\right).
}
\]
Отсюда, при больших \(n\) ,
\[
z_{n,p}\approx
\mathcal N\left(
z_p,
\frac{p(1-p)}{n\rho^2(z_p)}
\right).
\]
Выборочная медиана
Выборочной медианой для выборки \(X_1,\dots,X_n\) называется
\[
\widehat\mu=
\begin{cases}
X_{(k+1)}, & n=2k+1,\\[6pt]
\dfrac{X_{(k)}+X_{(k+1)}}{2}, & n=2k.
\end{cases}
\]
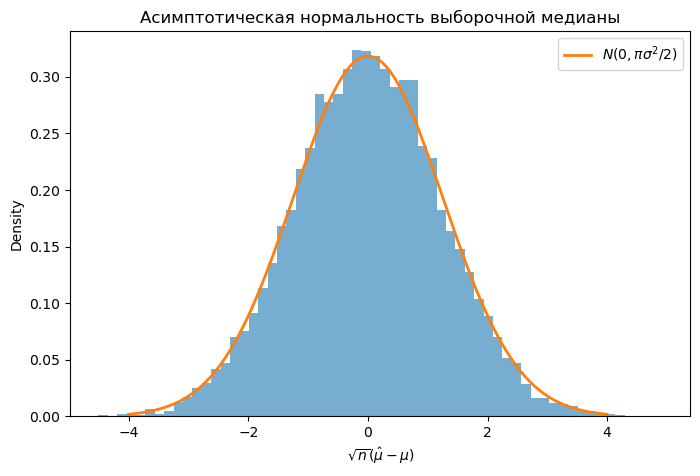
Для непрерывного распределения с медианой \(\mu\) и плотностью \(\rho(\mu)>0\) теорема о выборочном квантиле при \(p=1/2\) даёт
\[
\boxed{
\sqrt n(\widehat\mu-\mu)
\xrightarrow{d}
\mathcal N\left(0,\frac{1}{4\rho^2(\mu)}\right).
}
\]
Пример: медиана нормального распределения
Пусть
\[X_i\sim\mathcal N(\mu,\sigma^2).\]
Медиана равна \(\mu\) , а
\[
\rho(\mu)=\frac{1}{\sigma\sqrt{2\pi}}.
\]
Поэтому
\[
\frac{1}{4\rho^2(\mu)}
=\frac{\pi\sigma^2}{2},
\]
и
\[
\boxed{
\sqrt n(\widehat\mu-\mu)
\xrightarrow{d}
\mathcal N\left(0,\frac{\pi\sigma^2}{2}\right).
}
\]
Для сравнения,
\[
\sqrt n(\overline X-\mu)
\xrightarrow{d}\mathcal N(0,\sigma^2).
\]
Таким образом, при нормальной модели выборочное среднее асимптотически эффективнее медианы, но медиана значительно устойчивее к выбросам.
Show Python code
import numpy as npimport matplotlib.pyplot as plt= np.random.default_rng(42 )= 0.0 , 1.0 = 100 = 10_000 = rng.normal(mu, sigma, size= (R, n))= np.median(samples, axis= 1 )= np.sqrt(n) * (medians - mu)= np.linspace(- 4 , 4 , 500 )= np.pi * sigma** 2 / 2 = (1 / np.sqrt(2 * np.pi * asymptotic_var)* np.exp(- x** 2 / (2 * asymptotic_var))= (8 , 5 ))= 60 , density= True , alpha= 0.6 )= 2 ,= r' $ N ( 0, \ pi \s igma ^ 2/2 ) $ ' )r' $\s qrt{n} ( \ hat \m u- \m u ) $ ' )'Density' )'Асимптотическая нормальность выборочной медианы' )
Метод максимального правдоподобия
Пусть
\[\mathcal P=\{P_\theta:\theta\in\Theta\}\]
— доминируемое семейство распределений с плотностью \(\rho_\theta(x)\) .
Функция правдоподобия
Для независимой одинаково распределённой выборки \(X_1,\dots,X_n\) совместная плотность имеет вид
\[
\boxed{
f_\theta(X_1,\dots,X_n)
=
\prod_{i=1}^n\rho_\theta(X_i).
}
\]
Если рассматривать наблюдения \(x_1,\dots,x_n\) как фиксированные, а \(\theta\) — как переменную, эта же функция называется функцией правдоподобия :
\[
L(\theta;x_1,\dots,x_n)
=
\prod_{i=1}^n\rho_\theta(x_i).
\]
Логарифмическая функция правдоподобия
Вместо произведения обычно удобнее максимизировать его логарифм:
\[
\boxed{
\ell(\theta)
=
\log L(\theta)
=
\sum_{i=1}^n\log\rho_\theta(X_i).
}
\]
Поскольку логарифм строго возрастает,
\[
\arg\max_{\theta\in\Theta}L(\theta)
=
\arg\max_{\theta\in\Theta}\ell(\theta).
\]
Оценка максимального правдоподобия
Оценкой максимального правдоподобия (MLE) параметра \(\theta\) называется статистика
\[
\boxed{
\widehat\theta_{\mathrm{MLE}}(\mathbf X)
\in
\arg\max_{\theta\in\Theta}
L(\theta;X_1,\dots,X_n).
}
\]
На практике обычно:
записывают \(L(\theta)\) ;
переходят к \(\ell(\theta)=\log L(\theta)\) ;
находят критические точки из \(\ell'(\theta)=0\) ;
проверяют границы пространства параметров и убеждаются, что найден максимум.
Важно: если пространство параметров дискретно, дифференцирование может быть неприменимо. Тогда удобно сравнивать соседние значения правдоподобия, например \(L(\theta+1)/L(\theta)\) .
Пример: \(\operatorname{Bin}(m,p)\) , параметр \(p\) неизвестен
Пусть
\[X_1,\dots,X_n\overset{iid}{\sim}\operatorname{Bin}(m,p),\]
где \(m\) известно. Тогда
\[
L(p)
=\prod_{i=1}^n\binom{m}{X_i}p^{X_i}(1-p)^{m-X_i}.
\]
С точностью до слагаемого, не зависящего от \(p\) ,
\[
\ell(p)
=
\left(\sum_{i=1}^nX_i\right)\log p
+
\left(nm-\sum_{i=1}^nX_i\right)\log(1-p).
\]
Из \(\ell'(p)=0\) получаем
\[
\boxed{\widehat p_{\mathrm{MLE}}=\frac{\overline X}{m}.}
\]
Пример: нормальное распределение
Пусть
\[X_1,\dots,X_n\sim\mathcal N(\mu,\sigma^2).\]
Если оба параметра неизвестны, максимизация логарифмического правдоподобия приводит к
\[
\boxed{\widehat\mu_{\mathrm{MLE}}=\overline X},
\]
и
\[
\boxed{
\widehat{\sigma^2}_{\mathrm{MLE}}
=\frac1n\sum_{i=1}^n(X_i-\overline X)^2.
}
\]
Обратите внимание: MLE для \(\sigma^2\) использует делитель \(n\) , а не \(n-1\) , поэтому при конечном \(n\) эта оценка смещена.
Связь трёх идей
В этой части курса появляются три разных способа строить оценки:
метод моментов: сопоставляем теоретические и эмпирические средние некоторых функций \(g(X)\) ;выборочные квантили: оцениваем положение распределения через порядковые статистики;метод максимального правдоподобия: выбираем параметр, при котором наблюдённая выборка наиболее правдоподобна.
Эти методы могут приводить как к одинаковым, так и к различным оценкам. После построения оценки нас интересуют её свойства: состоятельность, смещение, дисперсия, асимптотическая нормальность и эффективность.