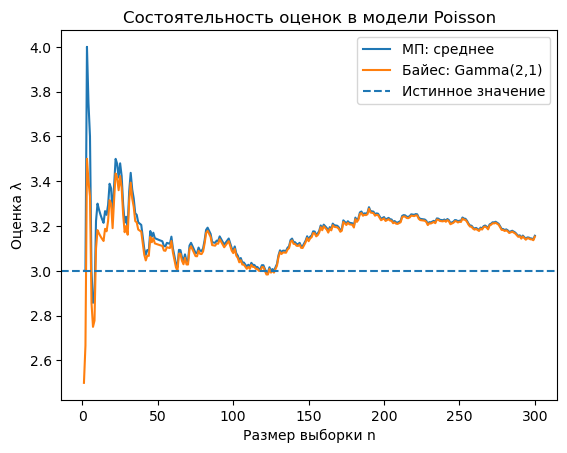
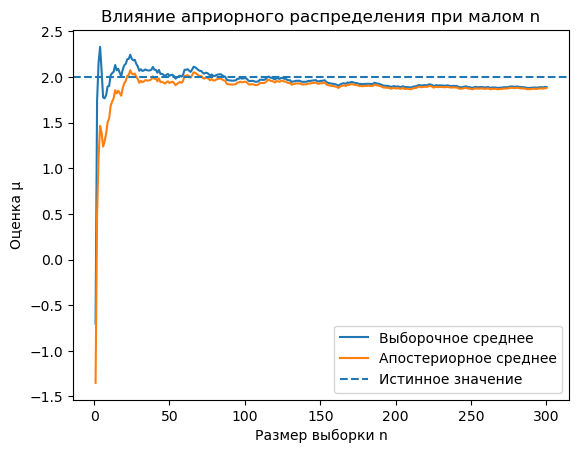
В частотном подходе неизвестный параметр \(\theta\) фиксирован. В байесовском подходе параметр рассматривается как случайная величина \(\Theta\) с априорным распределением\(\pi\), а данные \(X=(X_1,\ldots,X_n)\) имеют условное распределение \(P_\theta\) при \(\Theta=\theta\).
NoteОбозначения
\(\pi(\theta)\) (или \(q(\theta)\)) — априорная плотность / масса;
\(L(\theta;x)=f(x\mid\theta)\) — функция правдоподобия;
\(\pi(\theta\mid x)\) — апостериорная плотность / масса;
\(\delta(X)\) — статистическое решающее правило (оценка).
Для дискретных параметров интегралы заменяются суммами. Не следует путать априорное распределение параметра и распределение наблюдений.
1.1 Формула Байеса
ImportantОпределение 1. Априорное распределение
Распределение \(\pi\) параметра \(\Theta\) до наблюдения данных называется априорным.
Знаменатель \(m(x)\) называется маргинальной плотностью данных (evidence). В вычислениях удобно писать \(\pi(\theta\mid x)\propto L(\theta;x)\pi(\theta)\) и затем нормировать.
Для дискретного параметра: \[P(\Theta=t\mid X=x)=\frac{P(X=x\mid\Theta=t)P(\Theta=t)}{\sum_sP(X=x\mid\Theta=s)P(\Theta=s)}.\]
1.2 Байесовская оценка и функция потерь
ImportantОпределение 3. Байесовская оценка при квадратичной потере
При потере \(\ell(a,\theta)=(a-\theta)^2\) байесовская оценка равна \[\boxed{\widehat\theta_B(X)=\mathbb E[\Theta\mid X].}\] Для существования требуется конечный соответствующий апостериорный второй момент (либо достаточно условий, обеспечивающих конечный риск).
NoteОпределение 4. Байесовский риск и оптимальность
Для произвольной потери \(\ell(a,\theta)\) частотный риск правила \(\delta\): \[R(\theta,\delta)=\mathbb E_\theta[\ell(\delta(X),\theta)].\] Байесовский риск: \[r(\pi,\delta)=\int_\Theta R(\theta,\delta)\,\pi(d\theta).\] Правило \(\delta^*\)байесовски оптимально, если \(r(\pi,\delta^*)\le r(\pi,\delta)\) для любого допустимого \(\delta\). Строгое неравенство для каждого другого правила, как в исходном конспекте, вообще говоря, не требуется: оптимальных правил может быть несколько.
TipТеорема. Оптимальность апостериорного среднего
При квадратичной потере и конечных вторых моментах оптимальное правило: \[\delta^*(X)=\mathbb E[\Theta\mid X].\]Доказательство. Для фиксированного \(x\) и \(m(x)=\mathbb E[\Theta\mid X=x]\): \[\mathbb E[(a-\Theta)^2\mid X=x]=(a-m(x))^2+\operatorname{Var}(\Theta\mid X=x).\] Минимум достигается при \(a=m(x)\). Интегрирование по \(X\) даёт минимум байесовского риска. \(\square\)
Потеря \(\mathbf1\{a\ne\theta\}\) для дискретного параметра: апостериорная мода (MAP).
Поэтому формула «байесовская оценка = апостериорное среднее» предполагает квадратичную потерю.
2 Сопряжённые семейства
ImportantОпределение 5. Сопряжённое семейство
Семейство априорных распределений \(\{\pi_\eta:\eta\in H\}\) называется сопряжённым к модели \(\{P_\theta\}\), если апостериорное распределение принадлежит тому же семейству для всех допустимых выборок (с обновлённым гиперпараметром \(\eta'=T(\eta,x)\)).
2.1 Основные пары «модель — априорное распределение»
Здесь \(S=\sum_iX_i\), \(M=\max_iX_i\); Gamma использует параметризацию shape–rate: \[f(\lambda)=\frac{\beta^\alpha}{\Gamma(\alpha)}\lambda^{\alpha-1}e^{-\beta\lambda},\quad \mathbb E\lambda=\frac{\alpha}{\beta}.\] Для \(\operatorname{InvGamma}(\alpha,\beta)\) плотность \(\propto v^{-\alpha-1}e^{-\beta/v}\) и среднее \(\beta/(\alpha-1)\) при \(\alpha>1\).
2.2 Beta–Binomial
Пусть \(X_i\sim\operatorname{Bin}(m,p)\), \(p\sim\operatorname{Beta}(\alpha,\beta)\), \(S=\sum_iX_i\). Тогда \[L(p;x)\propto p^S(1-p)^{nm-S},\qquad \pi(p)\propto p^{\alpha-1}(1-p)^{\beta-1},\]\[p\mid X\sim\operatorname{Beta}(\alpha+S,\beta+nm-S),\qquad \widehat p_B=\frac{\alpha+S}{\alpha+\beta+nm}.\] Если \(\alpha,\beta\) фиксированы, \(\widehat p_B\xrightarrow{P}p_0\) по ЗБЧ при истинном \(p_0\).
2.3 Gamma–Poisson
Для \(X_i\sim\operatorname{Pois}(\lambda)\), \(\lambda\sim\operatorname{Gamma}(\alpha,\beta)\): \[\pi(\lambda\mid x)\propto\lambda^{\alpha+S-1}e^{-(\beta+n)\lambda},\]\[\boxed{\widehat\lambda_B=\frac{\alpha+S}{\beta+n}.}\]
2.4 Gamma–Exponential: параметр интенсивности
Если \(f(x\mid\lambda)=\lambda e^{-\lambda x}\mathbf1_{x\ge0}\), то \[\lambda\mid X\sim\operatorname{Gamma}(\alpha+n,\beta+S),\quad \widehat\lambda_B=\frac{\alpha+n}{\beta+S}\xrightarrow{P}\lambda_0.\]
WarningЕсли \(\theta\) — масштаб, а не интенсивность
При \(f(x\mid\theta)=\theta^{-1}e^{-x/\theta}\), \(\theta>0\), сопряжённое распределение — обратное гамма-распределение: \[\theta\sim\operatorname{InvGamma}(\alpha,\beta)\implies\theta\mid X\sim\operatorname{InvGamma}(\alpha+n,\beta+S),\]\[\widehat\theta_B=\frac{\beta+S}{\alpha+n-1},\quad\alpha+n>1.\] Параметризацию экспоненциального распределения всегда нужно оговаривать.
2.5 Нормальная модель с известной дисперсией
Если \(X_i\mid\mu\sim N(\mu,\sigma^2)\) и \(\mu\sim N(a,\tau^2)\), то \[v_n=\left(\frac1{\tau^2}+\frac n{\sigma^2}\right)^{-1},\qquad m_n=v_n\left(\frac a{\tau^2}+\frac{n\bar X}{\sigma^2}\right),\]\[\mu\mid X\sim N(m_n,v_n),\qquad\widehat\mu_B=m_n.\]
TipВывод дополнением до квадрата
Логарифм апостериорной плотности с точностью до константы равен \[-\frac{(\mu-a)^2}{2\tau^2}-\frac{\sum_i(X_i-\mu)^2}{2\sigma^2}=-\frac{(\mu-m_n)^2}{2v_n}+C(x).\] При фиксированных \(a,\tau^2,\sigma^2\) коэффициент при \(\bar X\) стремится к 1, поэтому \(m_n\xrightarrow{P}\mu_0\).
2.6 Равномерная модель и распределение Парето
Если \(X_i\mid\theta\sim U(0,\theta)\), то \(L(\theta;x)=\theta^{-n}\mathbf1_{\theta\ge M}\) (при неотрицательных наблюдениях).
Для априорного \(\operatorname{Pareto}(b,\alpha)\) с плотностью \[\pi(\theta)=\alpha b^\alpha\theta^{-\alpha-1}\mathbf1_{\theta\ge b},\] получаем \(\theta\mid X\sim\operatorname{Pareto}(c,\alpha+n)\), \(c=\max(b,M)\), и \[\widehat\theta_B=\frac{\alpha+n}{\alpha+n-1}c\quad(\alpha+n>1).\] Если истинное \(\theta_0\ge b\), то \(M\to\theta_0\) почти наверное, значит оценка состоятельна.
При \(0\le M<1\) апостериорная плотность пропорциональна \(\theta^{-n}\mathbf1_{[M,1]}(\theta)\). Для \(0<M<1\): \[\widehat\theta_B=\frac{\int_M^1 t^{1-n}dt}{\int_M^1 t^{-n}dt}.\] Для \(n\ge3\): \[\widehat\theta_B=\frac{n-1}{n-2}\frac{M^{2-n}-1}{M^{1-n}-1}.\] При \(n=2\): \(\widehat\theta_B=\frac{\log(1/M)}{M^{-1}-1}\); при \(n=1\): \(\widehat\theta_B=\frac{1-M}{\log(1/M)}\). Если \(M\to\theta_0\in(0,1)\), то апостериорная оценка всё равно стремится к \(\theta_0\) при \(n\to\infty\).
3 Априорное распределение Джеффриса
ImportantОпределение 6. Правило Джеффриса
Для одномерной регулярной модели с информацией Фишера от одного наблюдения\[I(\theta)=\mathbb E_\theta\left[\left(\frac{\partial}{\partial\theta}\log f(X\mid\theta)\right)^2\right],\] априорная плотность Джеффриса задаётся (с точностью до множителя) \[\boxed{\pi_J(\theta)\propto\sqrt{I(\theta)}.}\] Для векторного параметра \(\pi_J(\theta)\propto\sqrt{\det I(\theta)}\).
WarningВажные оговорки
Априорное распределение Джеффриса может быть несобственным (не интегрироваться в единицу). Использовать его можно, если полученное апостериорное распределение собственное. Формулы регулярной информации требуют условий дифференцируемости и интегрируемости; для модели \(U(0,\theta)\) с зависящим от параметра носителем стандартные регулярные тождества могут не выполняться.
3.1 Пример: Poisson
\[\log f(x\mid\lambda)=-\lambda+x\log\lambda-\log(x!),\qquad I(\lambda)=\frac1\lambda.\] Следовательно, \(\pi_J(\lambda)\propto\lambda^{-1/2}\), то есть формально \(\operatorname{Gamma}(1/2,0)\) (несобственное предельное обозначение). После \(n\ge1\) наблюдений: \[\lambda\mid X\sim\operatorname{Gamma}(S+1/2,n),\quad\boxed{\widehat\lambda_J=\frac{S+1/2}{n}=\bar X+\frac1{2n}.}\]
3.2 Пример: \(N(\mu,1)\)
\(I(\mu)=1\), значит \(\pi_J(\mu)\propto1\) на \(\mathbb R\) (несобственное равномерное распределение). При \(n\ge1\): \[\mu\mid X\sim N(\bar X,1/n),\qquad\boxed{\widehat\mu_J=\bar X.}\]
TipСравнение с сопряжёнными априорными распределениями
Для Poisson с \(\operatorname{Gamma}(\alpha,\beta)\) получаем \((S+\alpha)/(n+\beta)\); при Джеффрисе — \((S+1/2)/n\). Для нормальной модели с априорным \(N(a,\tau^2)\) получаем взвешенное среднее, а при Джеффрисе — \(\bar X\).
4 Состоятельность: как проверять
ImportantОпределение
Оценка \(\delta_n(X_1,\ldots,X_n)\)состоятельна в точке \(\theta_0\), если при выборке из \(P_{\theta_0}\)\[\delta_n\xrightarrow[n\to\infty]{P_{\theta_0}}\theta_0.\] Состоятельность — частотное свойство, даже если правило построено байесовским способом.
Полезные факты: \(\bar X\xrightarrow{P}\mathbb E_{\theta_0}X_1\) по ЗБЧ; для \(U(0,\theta_0)\)\[P_{\theta_0}(M_n\le t)=(t/\theta_0)^n,\quad 0\le t\le\theta_0,\qquad M_n\xrightarrow{a.s.}\theta_0.\] Для \(U(\theta_0,\theta_0+1)\) минимум \(m_n\to\theta_0\), максимум \(M_n\to\theta_0+1\) почти наверное.
Если истинное значение параметра исключено априорным распределением, байесовская оценка может быть несостоятельной. В частности, при априорном \(\operatorname{Bern}(p)\) параметр может принимать только 0 или 1, поэтому состоятельность следует проверять только для \(\theta_0\in\{0,1\}\) в рамках байесовской модели.
5 Дискретные априорные распределения и сдвиг равномерного закона
5.1 Двухточечный приор для нормального среднего
Пусть \(X_i\mid\theta\sim N(\theta,1)\) и \(P(\Theta=1)=p\), \(P(\Theta=0)=1-p\), \(0<p<1\). Тогда \[\frac{P(\Theta=1\mid x)}{P(\Theta=0\mid x)}=\frac p{1-p}\exp\left(S-\frac n2\right),\]\[\boxed{\widehat\theta_B=P(\Theta=1\mid X)=\frac{p e^{S-n/2}}{1-p+p e^{S-n/2}}.}\] При \(\theta_0=1\) логарифм апостериорных шансов \(=\log(p/(1-p))+n/2+O_P(\sqrt n)\to+\infty\), а при \(\theta_0=0\) он стремится к \(-\infty\). Значит оценка состоятельна на \(\{0,1\}\). При \(p=0\) или \(1\) приор вырожден и вывод меняется.
5.2 Пуассоновский приор для \(U(\theta,\theta+1)\)
Пусть \(\Theta\sim\operatorname{Pois}(1)\), так что \(\Theta=k\in\{0,1,2,\ldots\}\) с весами \(e^{-1}/k!\). Для наблюдений \(x\) правдоподобие при \(k\) равно \[L(k;x)=\mathbf1\{k\le m,\ M\le k+1\},\qquad m=\min_i x_i,\quad M=\max_i x_i.\] Следовательно, \[P(\Theta=k\mid x)=\frac{\frac1{k!}\mathbf1\{M-1\le k\le m\}}{\sum_{j\ge0}\frac1{j!}\mathbf1\{M-1\le j\le m\}},\]\[\boxed{\widehat\theta_B=\frac{\sum_{k\ge0}\frac{k}{k!}\mathbf1\{M-1\le k\le m\}}{\sum_{k\ge0}\frac1{k!}\mathbf1\{M-1\le k\le m\}}.}\] Интервал \([M-1,m]\) имеет длину \(1-(M-m)\), которая стремится к нулю. При истинном целом \(\theta_0\ge0\) апостериорное распределение концентрируется в \(\theta_0\) и оценка состоятельна. Для нецелого истинного параметра модель приора неверно специфицирована, и универсальная состоятельность не гарантируется.
6 Численные иллюстрации
В следующих экспериментах сравним байесовскую оценку и оценку максимального правдоподобия. Численный эксперимент иллюстрирует, но не заменяет доказательство состоятельности.
Show Python code
import numpy as npimport matplotlib.pyplot as pltrng = np.random.default_rng(2026)n_values = np.arange(1, 301)lam0 =3.0x = rng.poisson(lam0, size=n_values[-1])s = np.cumsum(x)alpha, beta =2.0, 1.0plt.plot(n_values, s/n_values, label="МП: среднее")plt.plot(n_values, (alpha+s)/(beta+n_values), label="Байес: Gamma(2,1)")plt.axhline(lam0, linestyle="--", label="Истинное значение")plt.xlabel("Размер выборки n")plt.ylabel("Оценка λ")plt.title("Состоятельность оценок в модели Poisson")plt.legend()plt.show()