В исходной главе параметры модели — \(\theta\) и \(\sigma^2\); \(L=\operatorname{col}(Z)\) — известное \(k\)-мерное подпространство, \(\ell=Z\theta\in L\) — неизвестное среднее.
ImportantДва разных набора предположений
Для формул несмещённости и ковариации МНК нормальность не нужна. Для точных \(\chi^2\), \(t\), \(F\)-распределений, независимости проекций и точных доверительных интервалов дополнительно требуется \(\varepsilon\sim N(0,\sigma^2 I_n)\).
1.1 Идентифицируемость
Полный столбцовый ранг \(Z\) эквивалентен положительной определённости \(Z^TZ\) и единственности координат \(\theta\). При недостаточном ранге проекция \(\widehat\ell\) всё ещё единственна, но \(\widehat\theta\) может быть неоднозначной.
2 2. Метод наименьших квадратов и ортогональная проекция
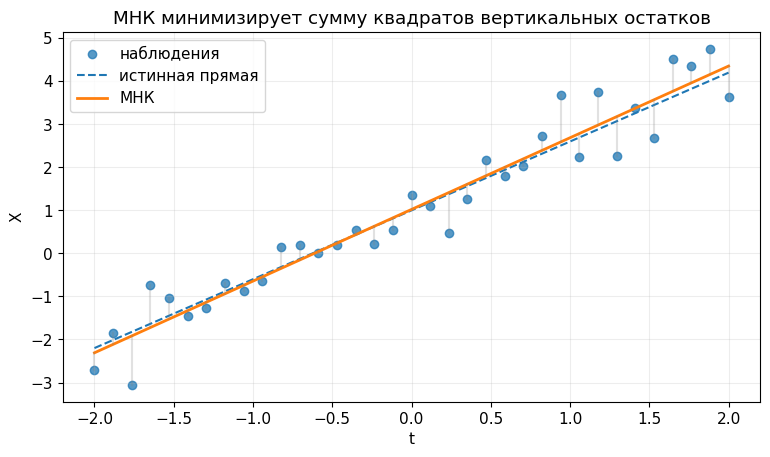
Определение.\(\widehat\theta=\arg\min_{u\in\mathbb R^k}\|X-Zu\|^2\). Разложение квадрата даёт
\[\|X-Zu\|^2=X^TX-2u^TZ^TX+u^TZ^TZu.\]
Дифференцируя по \(u\), получаем нормальные уравнения\(Z^TZ\widehat\theta=Z^TX\), следовательно,
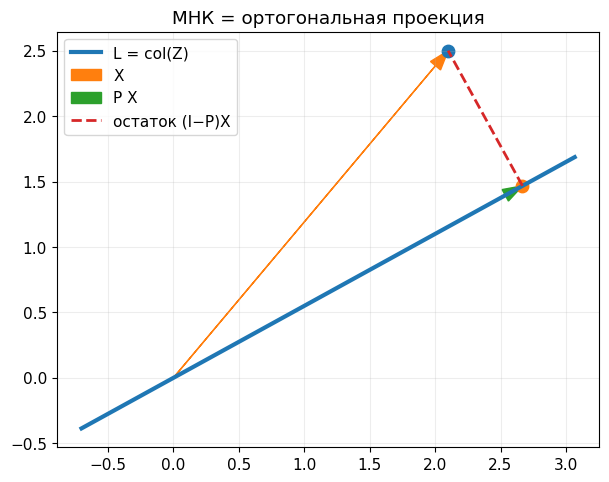
\(P_Z^T=P_Z\), \(P_Z^2=P_Z\); значит, \(P_Z\) — ортогональный проектор на \(L\). Остатки \(e=X-Z\widehat\theta=(I-P_Z)X\) лежат в \(L^\perp\), поэтому \(Z^Te=0\). Теорема Пифагора:
\[\|X\|^2=\|P_ZX\|^2+\|(I-P_Z)X\|^2.\]
TipКак распознать матрицу плана в задаче?
Если \(\mathbb E X_i=\beta_1+i\beta_2\), то строка \(i\) матрицы \(Z\) равна \((1,i)\). Если измеряются суммы \(a+b\), строка \((1,1)\); если только \(a\), строка \((1,0)\). Матрица плана кодирует математические ожидания, а не шум.
Show Python code
# Геометрия МНК: проекция точки на прямую в R²z=np.array([1.,.55]); z/=np.linalg.norm(z)x=np.array([2.1,2.5]); p=z*np.dot(z,x)t=np.linspace(-.8,3.5,100)fig,ax=plt.subplots(figsize=(7,6));ax.plot(t*z[0],t*z[1],lw=3,label='L = col(Z)')ax.arrow(0,0,*x,head_width=.1,length_includes_head=True,color='C1',label='X')ax.arrow(0,0,*p,head_width=.1,length_includes_head=True,color='C2',label='P X')ax.plot([p[0],x[0]],[p[1],x[1]],'--',color='C3',lw=2,label='остаток (I−P)X')ax.scatter(*x,s=80);ax.scatter(*p,s=80);ax.set_aspect('equal');ax.legend();ax.set_title('МНК = ортогональная проекция');plt.show()print('Скалярное произведение проекции и остатка:',np.dot(p,x-p))
Скалярное произведение проекции и остатка: 5.100045734843481e-16
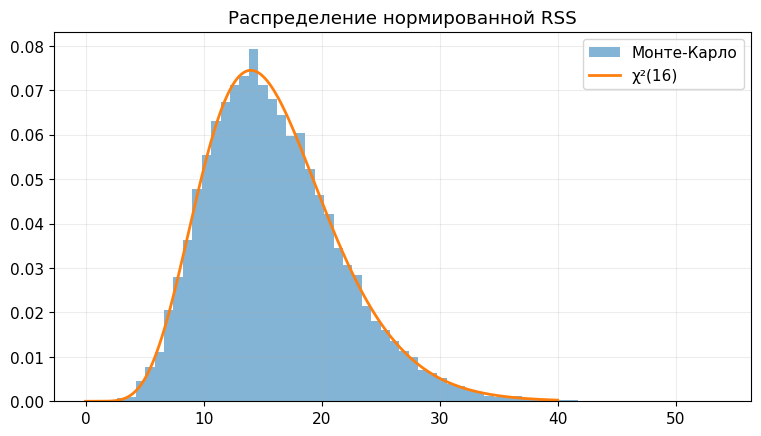
Число \(n-k\) — размерность пространства остатков, то есть число остаточных степеней свободы. Не путайте \(\widehat\sigma^2\) с гауссовской MLE \(\mathrm{RSS}/n\).
3.1 Теорема Гаусса—Маркова (дополнение)
Среди линейных несмещённых оценок \(\theta\) МНК имеет наименьшую ковариационную матрицу в порядке Лёвнера. Для любой \(AX\) с \(AZ=I_k\) запишем \(A=(Z^TZ)^{-1}Z^T+D\), где \(DZ=0\). Тогда
5 5. Гауссовская модель: проекции и точные распределения
Предположим теперь \(X\sim N(Z\theta,\sigma^2I_n)\).
5.1 Теорема об ортогональных гауссовских проекциях
Если \(L_1,\ldots,L_r\) попарно ортогональны, то \(P_{L_1}X,\ldots,P_{L_r}X\)независимы, поскольку совместно нормальны и их попарные ковариации равны нулю.
Некоррелированность проекций следует уже из сферической ковариации, но их независимость в общем случае нет. Именно нормальность обеспечивает точные распределения \(t\) и \(F\).
5.2 Распределения, которые нужно знать
Если \(U\sim\chi^2_r\), \(V\sim\chi^2_s\) независимы, то \((U/r)/(V/s)\sim F_{r,s}\). Если \(G\sim N(0,1)\) и \(V\sim\chi^2_\nu\) независимы, то \(G/\sqrt{V/\nu}\sim t_\nu\).
Show Python code
# Монте-Карло: распределение RSS/sigma² и независимость оценокB=18000; N=18; T=np.linspace(-1,1,N); A=np.column_stack([np.ones(N),T]); K=2E=rng.normal(size=(B,N)); H=A@inv(A.T@A)@A.T; coef=E@A@inv(A.T@A); rss=np.sum((E@(np.eye(N)-H))**2,axis=1)fig,ax=plt.subplots();ax.hist(rss,bins=65,density=True,alpha=.55,label='Монте-Карло');q=np.linspace(0,40,400);ax.plot(q,stats.chi2.pdf(q,N-K),lw=2,label=f'χ²({N-K})');ax.legend();ax.set_title('Распределение нормированной RSS');plt.show()print('Корреляция оценки наклона и RSS:',np.corrcoef(coef[:,1],rss)[0,1])
Корреляция оценки наклона и RSS: 0.0020482103800153195
6 6. Точные доверительные интервалы и статистические выводы
Пусть \(A=(Z^TZ)^{-1}\) и \(a_{jj}\) — его диагональный элемент. Тогда
Односторонний интервал из пособия: если \(z_{1-\gamma}=\chi^2_{n-k;1-\gamma}\), то \(\bigl(0,(n-k)\widehat\sigma^2/z_{1-\gamma}\bigr)\) имеет доверительную вероятность \(\gamma\).
7 7. Взвешенный МНК, коррелированные ошибки и «отбеливание» (дополнение)
В задачах 2, 5 и 7 встречается \(\operatorname{Cov}(\varepsilon)=\sigma^2\Sigma\) с известной положительно определённой \(\Sigma\). Тогда обобщённый МНК минимизирует
Если \(C=\Sigma^{-1/2}\), то \(Y=CX\), \(W=CZ\) и \(Y=W\theta+\eta\) с \(\operatorname{Cov}\eta=\sigma^2I\). Таким образом, GLS — обычный МНК после «отбеливания».
При нормальности нормированный взвешенный RSS имеет \(\chi^2_{n-k}\)-распределение и независим от GLS-оценки. Если \(\Sigma\) неизвестна, эти точные выводы нельзя автоматически переносить на оценённую матрицу.
7.1 Коррелированный шум: накопленные ошибки
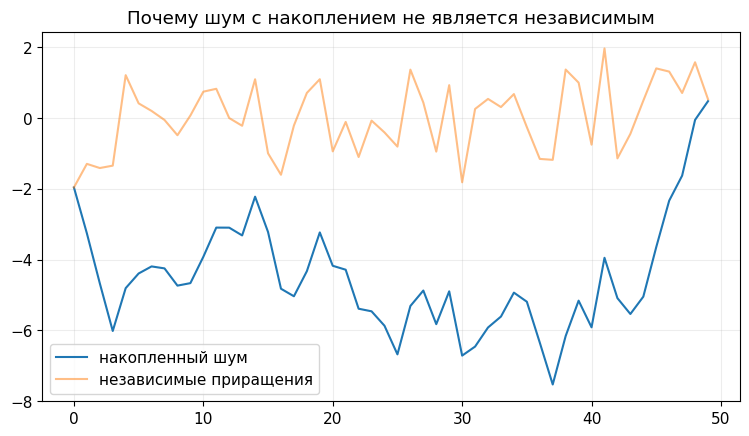
Если \(X_i=\beta_1+i\beta_2+\varepsilon_0+\cdots+\varepsilon_i\) и независимые \(\varepsilon_j\sim N(0,\sigma^2)\), то
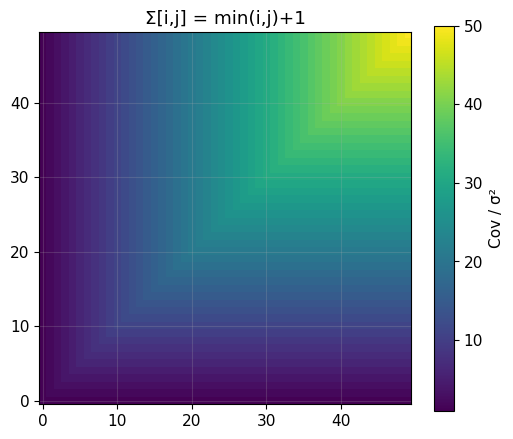
Матрица \(\Sigma_{ij}=\min(i,j)+1\) — не диагональная. Альтернатива: взять первые разности \(X_i-X_{i-1}=\beta_2+\varepsilon_i\) для \(i\ge1\); при этом \(X_0=\beta_1+\varepsilon_0\). Это полезное преобразование, но для оптимальной совместной оценки \(\beta_1,\beta_2\) важно учитывать весь преобразованный вектор.
Show Python code
# Накопленные ошибки: одна траектория и ковариационная матрицаn=50;eps=rng.normal(size=n);walk=np.cumsum(eps);idx=np.arange(n);Sigma=np.minimum.outer(idx,idx)+1fig,ax=plt.subplots();ax.plot(idx,walk,label='накопленный шум');ax.plot(idx,eps,alpha=.5,label='независимые приращения');ax.legend();ax.set_title('Почему шум с накоплением не является независимым');plt.show()fig,ax=plt.subplots(figsize=(6,5));im=ax.imshow(Sigma,cmap='viridis',origin='lower');fig.colorbar(im,ax=ax,label='Cov / σ²');ax.set_title('Σ[i,j] = min(i,j)+1');plt.show()
Show Python code
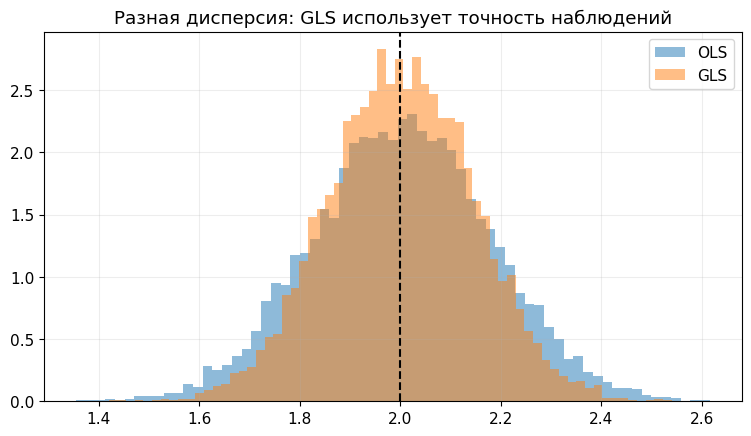
# Разная точность измерений: сравнение OLS и GLSB=8000;n=35;t=np.linspace(-2,2,n);Z=np.column_stack([np.ones(n),t]);v=.3+2.5*(t>0)Y=Z@np.array([1.,2.])[:,None]+np.sqrt(v)[:,None]*rng.normal(size=(n,B))ols=solve(Z.T@Z,Z.T@Y);gls=solve(Z.T@(Z/v[:,None]),Z.T@(Y/v[:,None]))fig,ax=plt.subplots();ax.hist(ols[1],bins=65,density=True,alpha=.5,label='OLS');ax.hist(gls[1],bins=65,density=True,alpha=.5,label='GLS');ax.axvline(2,color='black',ls='--');ax.legend();ax.set_title('Разная дисперсия: GLS использует точность наблюдений');plt.show()print('Дисперсия оценки наклона OLS:',np.var(ols[1]),'GLS:',np.var(gls[1]))
Дисперсия оценки наклона OLS: 0.03122071327540109 GLS: 0.020795964561147996
8 8. Дополнительные инструменты для задач
8.1 Геометрия нормальной выборки
Для \(X_1,\ldots,X_n\overset{\rm iid}{\sim}N(a,\sigma^2)\) возьмите \(L=\operatorname{span}\{\mathbf1\}\). Тогда \(P_LX=\overline X\mathbf1\), а \(\|(I-P_L)X\|^2=\sum_i(X_i-\overline X)^2\). Из теоремы о проекциях следует независимость \(\overline X\) и \(S^2=n^{-1}\sum(X_i-\overline X)^2\), а также