Для независимой выборки \(X_1,\ldots,X_n\) проверяем простую гипотезу \(H_0:F=F_0\) против \(H_1:F\ne F_0\). В критериях Колмогорова и Крамера–фон Мизеса ниже предполагается непрерывная и полностью заданная\(F_0\). Если параметры оценены по тем же данным, стандартные критические значения в общем случае изменяются.
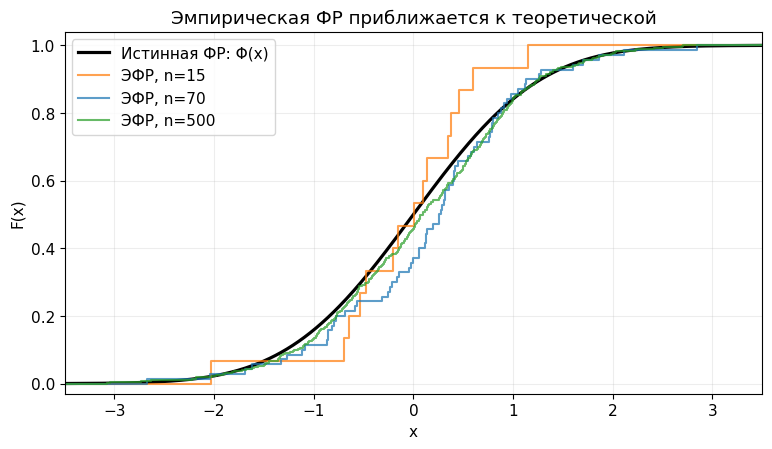
Пусть \(X=(X_1,\ldots,X_n)\) — выборка из распределения с функцией распределения \(F(x)\). Эмпирическая функция распределения определяется формулой \[
\widehat F_n(x)=\frac1n\sum_{i=1}^n\mathbf 1\{X_i\le x\}.
\] Это доля наблюдений, не превосходящих \(x\).
Свойства:\(\widehat F_n\) не убывает, непрерывна справа, принимает значения от \(0\) до \(1\) и имеет скачки в наблюдаемых точках.
ImportantТеорема Гливенко–Кантелли
Для независимых одинаково распределённых наблюдений \[
D_n=\sup_{x\in\mathbb R}|\widehat F_n(x)-F(x)|\xrightarrow{\text{п.н.}}0,\qquad n\to\infty.
\] То есть эмпирическая функция распределения равномерно приближается к истинной.
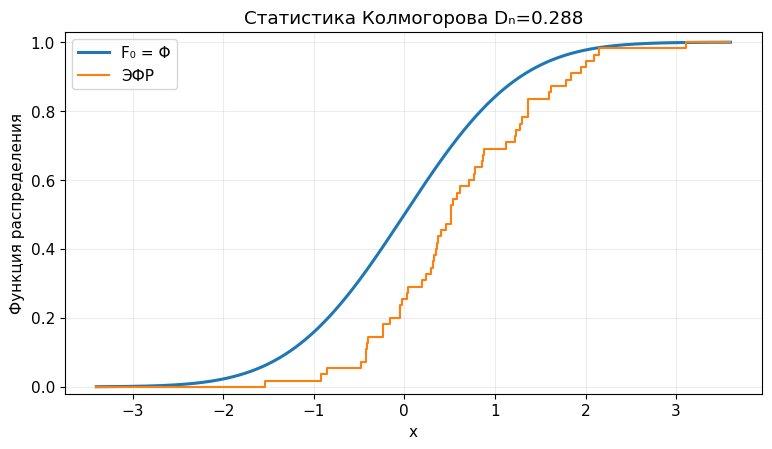
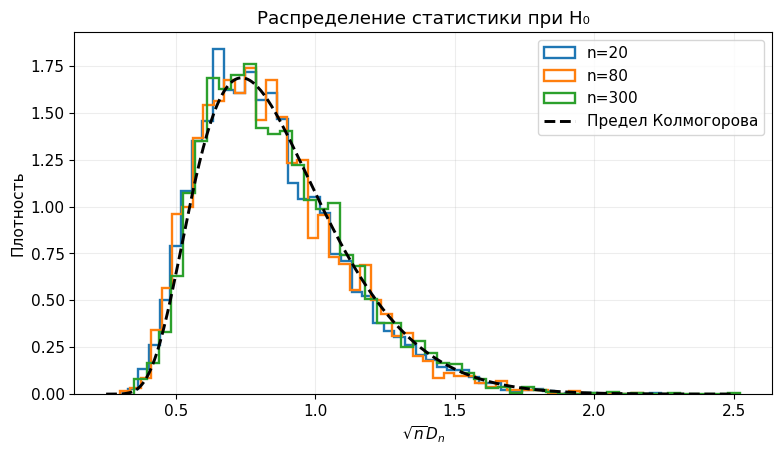
При верной \(H_0\) и непрерывной \(F_0\): \[
\sqrt n D_n\xrightarrow{d}K,\qquad
\mathbb P(K\le t)=1+2\sum_{k=1}^\infty(-1)^k e^{-2k^2t^2},\quad t>0.
\] Обозначим через \(k_{1-\alpha}\) квантиль порядка \(1-\alpha\) распределения \(K\). Асимптотический критерий: отвергнуть \(H_0\), если \[\sqrt n D_n\ge k_{1-\alpha}.\] В исходном конспекте рекомендовано использовать критерий при \(n\ge20\). Для полностью заданной непрерывной \(F_0\) существуют также точные конечновыборочные p-значения.
NoteПочему достаточно проверить точки скачков?
Между соседними наблюдениями \(\widehat F_n(x)\) постоянна, а \(F_0(x)\) не убывает и непрерывна. Максимум абсолютной разности на таком интервале достигается на одном из его концов (включая односторонние пределы). Поэтому достаточно вычислить две разности для каждого \(X_{(i)}\).
ImportantСостоятельность
Критерий Колмогорова состоятелен против любой фиксированной альтернативы \(F\ne F_0\): вероятность отклонить \(H_0\) стремится к \(1\).
B=3500fig,ax=plt.subplots()for nn in [20, 80, 300]: u=np.sort(rng.uniform(size=(B,nn)),axis=1) idx=np.arange(1,nn+1) d=np.maximum(np.max(idx/nn-u,axis=1),np.max(u-(idx-1)/nn,axis=1)) ax.hist(np.sqrt(nn)*d,bins=50,density=True,histtype='step',linewidth=1.7,label=f'n={nn}')t=np.linspace(.25,2.5,350)ax.plot(t,kstwobign.pdf(t),'k--',lw=2.1,label='Предел Колмогорова')ax.set(xlabel=r'$\sqrt{n}D_n$',ylabel='Плотность',title='Распределение статистики при H₀')ax.legend();plt.show()
3 3. Критерий Крамера–фон Мизеса–Смирнова
TipОпределение 2
Статистика омега-квадрат: \[
\omega^2=\int_{\mathbb R}\bigl(\widehat F_n(x)-F_0(x)\bigr)^2\,dF_0(x).
\] Для непрерывной \(F_0\) её удобно вычислять через порядковые статистики: \[
\boxed{\quad n\omega^2=\frac{1}{12n}+\sum_{i=1}^n\left(F_0(X_{(i)})-\frac{2i-1}{2n}\right)^2.\quad}
\]
ImportantПредельное распределение и критерий
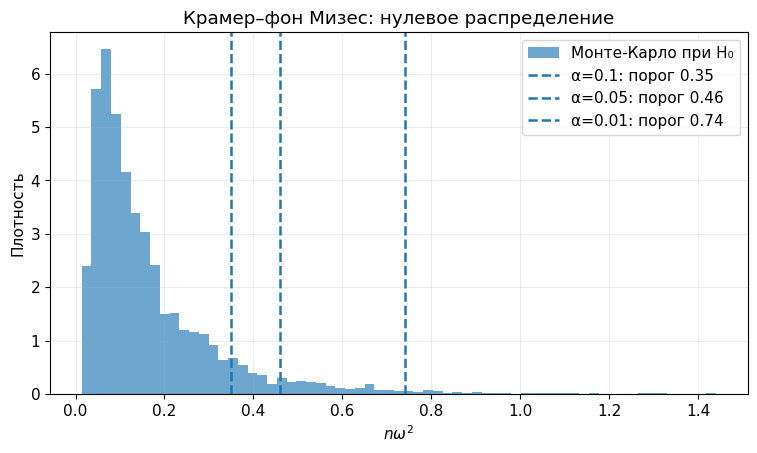
При \(H_0\) статистика \(n\omega^2\) сходится по распределению к фиксированному закону \(P\) (закону Крамера–фон Мизеса). Если \(y_{1-\alpha}\) — его квантиль, отклоняем \(H_0\), когда \[n\omega^2>y_{1-\alpha}.\] Критерий состоятелен против любой фиксированной альтернативы \(F\ne F_0\).
\(\alpha\)
0.5
0.15
0.1
0.05
0.025
0.01
0.001
\(y_{1-\alpha}\)
0.12
0.28
0.35
0.46
0.58
0.74
1.17
Значения из раздаточного материала округлены; при численных расчётах можно использовать реализацию в SciPy.
B=4500;n=75u=np.sort(rng.uniform(size=(B,n)),axis=1)w=1/(12*n)+np.sum((u-(2*np.arange(1,n+1)-1)/(2*n))**2,axis=1)fig,ax=plt.subplots()ax.hist(w,bins=65,density=True,alpha=.65,label='Монте-Карло при H₀')for a, val in [(.1,.35),(.05,.46),(.01,.74)]: ax.axvline(val,ls='--',lw=1.8,label=f'α={a}: порог {val}')ax.set(xlabel=r'$n\omega^2$',ylabel='Плотность',title='Крамер–фон Мизес: нулевое распределение')ax.legend();plt.show()
4 4. Критерий \(\chi^2\) Пирсона
Пусть \(B_1,\dots,B_n\) — независимые результаты с \(k\) категориями и вероятностями \(p=(p_1,\ldots,p_k)\). Обозначим \[X_i=\sum_{j=1}^n\mathbf 1\{B_j=i\},\qquad (X_1,\ldots,X_k)\sim\operatorname{Multinomial}(n,p).\] Проверяем \(H_0:p=p^0\) против \(H_1:p\ne p^0\), где все \(p_i^0>0\).
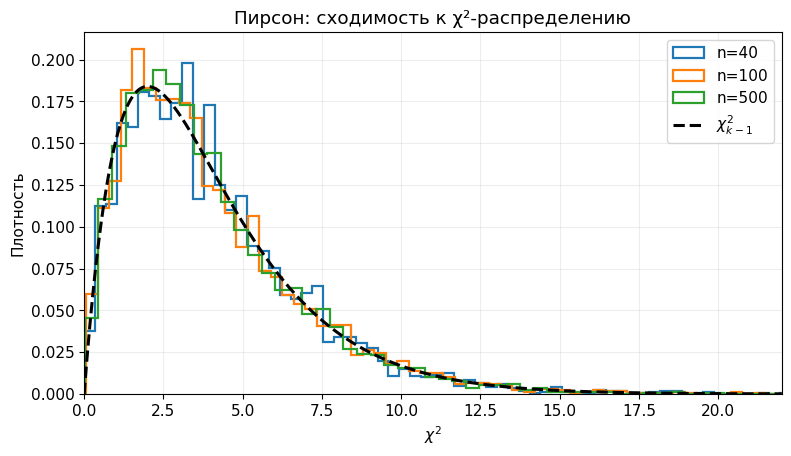
При верной \(H_0\) и фиксированном \(k\): \[\chi^2(X)\xrightarrow{d}\chi^2_{k-1},\quad n\to\infty.\] Критическая область асимптотического уровня \(\alpha\): \[R=\left\{x:\chi^2(x)>\chi^2_{k-1,1-\alpha}\right\}.\] Критерий состоятелен против любой фиксированной альтернативы \(p\ne p^0\).
WarningКогда приближение применимо?
В исходном конспекте дано практическое правило: \(n\ge50\) и \(np_i^0\ge5\) для каждой категории. Это эвристика, а не необходимое математическое условие. При малых ожидаемых частотах асимптотическое приближение может быть плохим.
Число степеней свободы \(k-1\) относится к полностью заданным вероятностям \(p^0\) без оценки параметров по выборке.
Show Python code
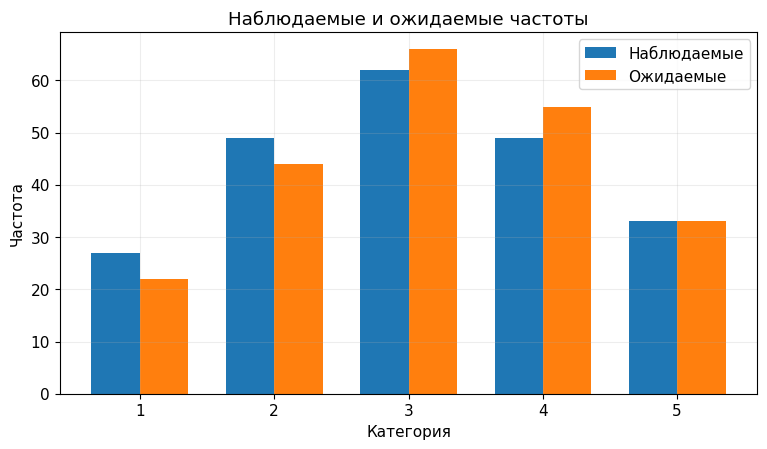
p0=np.array([.1,.2,.3,.25,.15]); n=220observed=rng.multinomial(n,p0)expected=n*p0stat=np.sum((observed-expected)**2/expected)pvalue=chi2.sf(stat,len(p0)-1)print('Наблюдения:',observed, 'Ожидания:',expected)print(f'χ²={stat:.3f}; p-value={pvalue:.4f}')fig,ax=plt.subplots()pos=np.arange(len(p0))ax.bar(pos-.18,observed,width=.36,label='Наблюдаемые')ax.bar(pos+.18,expected,width=.36,label='Ожидаемые')ax.set(xticks=pos,xticklabels=[f'{j+1}'for j in pos],xlabel='Категория',ylabel='Частота',title='Наблюдаемые и ожидаемые частоты')ax.legend();plt.show()
fig,ax=plt.subplots()for nn in [40,100,500]: counts=rng.multinomial(nn,p0,size=5000) vals=np.sum((counts-nn*p0)**2/(nn*p0),axis=1) ax.hist(vals,bins=65,density=True,histtype='step',lw=1.6,label=f'n={nn}')x=np.linspace(0,22,500)ax.plot(x,chi2.pdf(x,len(p0)-1),'k--',lw=2.2,label=r'$\chi^2_{k-1}$')ax.set(xlim=(0,22),xlabel=r'$\chi^2$',ylabel='Плотность',title='Пирсон: сходимость к χ²-распределению')ax.legend();plt.show()
5 5. Сравнение критериев: статистическая мощность
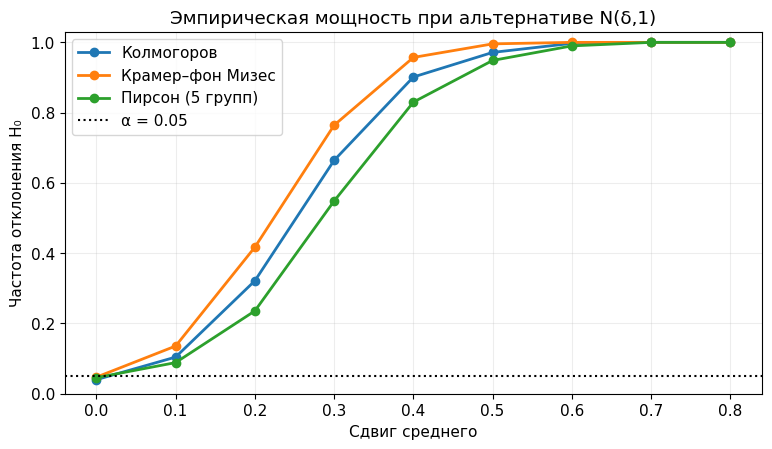
У трёх критериев различается способ измерения несогласия: Колмогоров использует максимальное отклонение функций распределения, Крамер–фон Мизес — интеграл квадрата отклонения, Пирсон — сумму квадратичных отклонений частот по заранее заданным категориям.
Следующий эксперимент сравнивает частоту отклонения \(H_0:N(0,1)\) при сдвиге среднего. Для Пирсона используются пять интервалов, равновероятных при \(H_0\). Это иллюстрация, а не универсальное ранжирование критериев.
Show Python code
B=700; n=85; alpha=.05edges=stats.norm.ppf([0,.2,.4,.6,.8,1])shifts=np.linspace(0,0.8,9)power=np.zeros((3,len(shifts)))for j,shift inenumerate(shifts): x=rng.normal(shift,size=(B,n)) z=np.sort(stats.norm.cdf(x),axis=1) idx=np.arange(1,n+1) d=np.maximum(np.max(idx/n-z,axis=1),np.max(z-(idx-1)/n,axis=1)) power[0,j]=np.mean(np.sqrt(n)*d>kstwobign.ppf(1-alpha)) w=1/(12*n)+np.sum((z-(2*idx-1)/(2*n))**2,axis=1) power[1,j]=np.mean(w>.46) counts=np.array([np.histogram(row,bins=edges)[0] for row in x]) chisq=np.sum((counts-n/5)**2/(n/5),axis=1) power[2,j]=np.mean(chisq>chi2.ppf(1-alpha,4))fig,ax=plt.subplots()for label,curve inzip(['Колмогоров','Крамер–фон Мизес','Пирсон (5 групп)'],power): ax.plot(shifts,curve,marker='o',lw=2,label=label)ax.axhline(alpha,ls=':',color='black',label='α = 0.05')ax.set(xlabel='Сдвиг среднего',ylabel='Частота отклонения H₀',ylim=(0,1.03),title='Эмпирическая мощность при альтернативе N(δ,1)')ax.legend();plt.show()